Un modello meteorologico è un elemento essenziale, ma non rappresenta automaticamente la previsione finale per un determinato luogo. Il lavoro che segue un run del modello contribuisce a collegare la sua rappresentazione dell’atmosfera con le condizioni rilevanti per chi si trova in una valle, su una montagna, in un’azienda agricola o lungo la costa.
Combinare gli output di diversi modelli
I servizi di previsione meteorologica ricevono simulazioni da modelli globali e regionali con griglie di diversa risoluzione, differenti rappresentazioni del terreno, cicli di aggiornamento e orizzonti previsionali. Anche le loro prestazioni variano in base al luogo, alla variabile meteorologica e alla situazione atmosferica. Di conseguenza, diversi modelli possono produrre previsioni differenti per lo stesso luogo e lo stesso momento. Le nostre guide ai modelli meteorologici illustrano questi principi di base nella Parte 1 e Parte 2.
Prima di poter confrontare o combinare gli output, è necessario assicurarsi che il loro significato sia coerente. Ciò comporta la verifica di coordinate, unità, intervalli temporali, altezze di misurazione e definizioni delle variabili. La velocità del vento e le raffiche, ad esempio, descrivono grandezze diverse. Un valore di temperatura si riferisce generalmente a un determinato momento, mentre le precipitazioni rappresentano un accumulo su un determinato periodo.
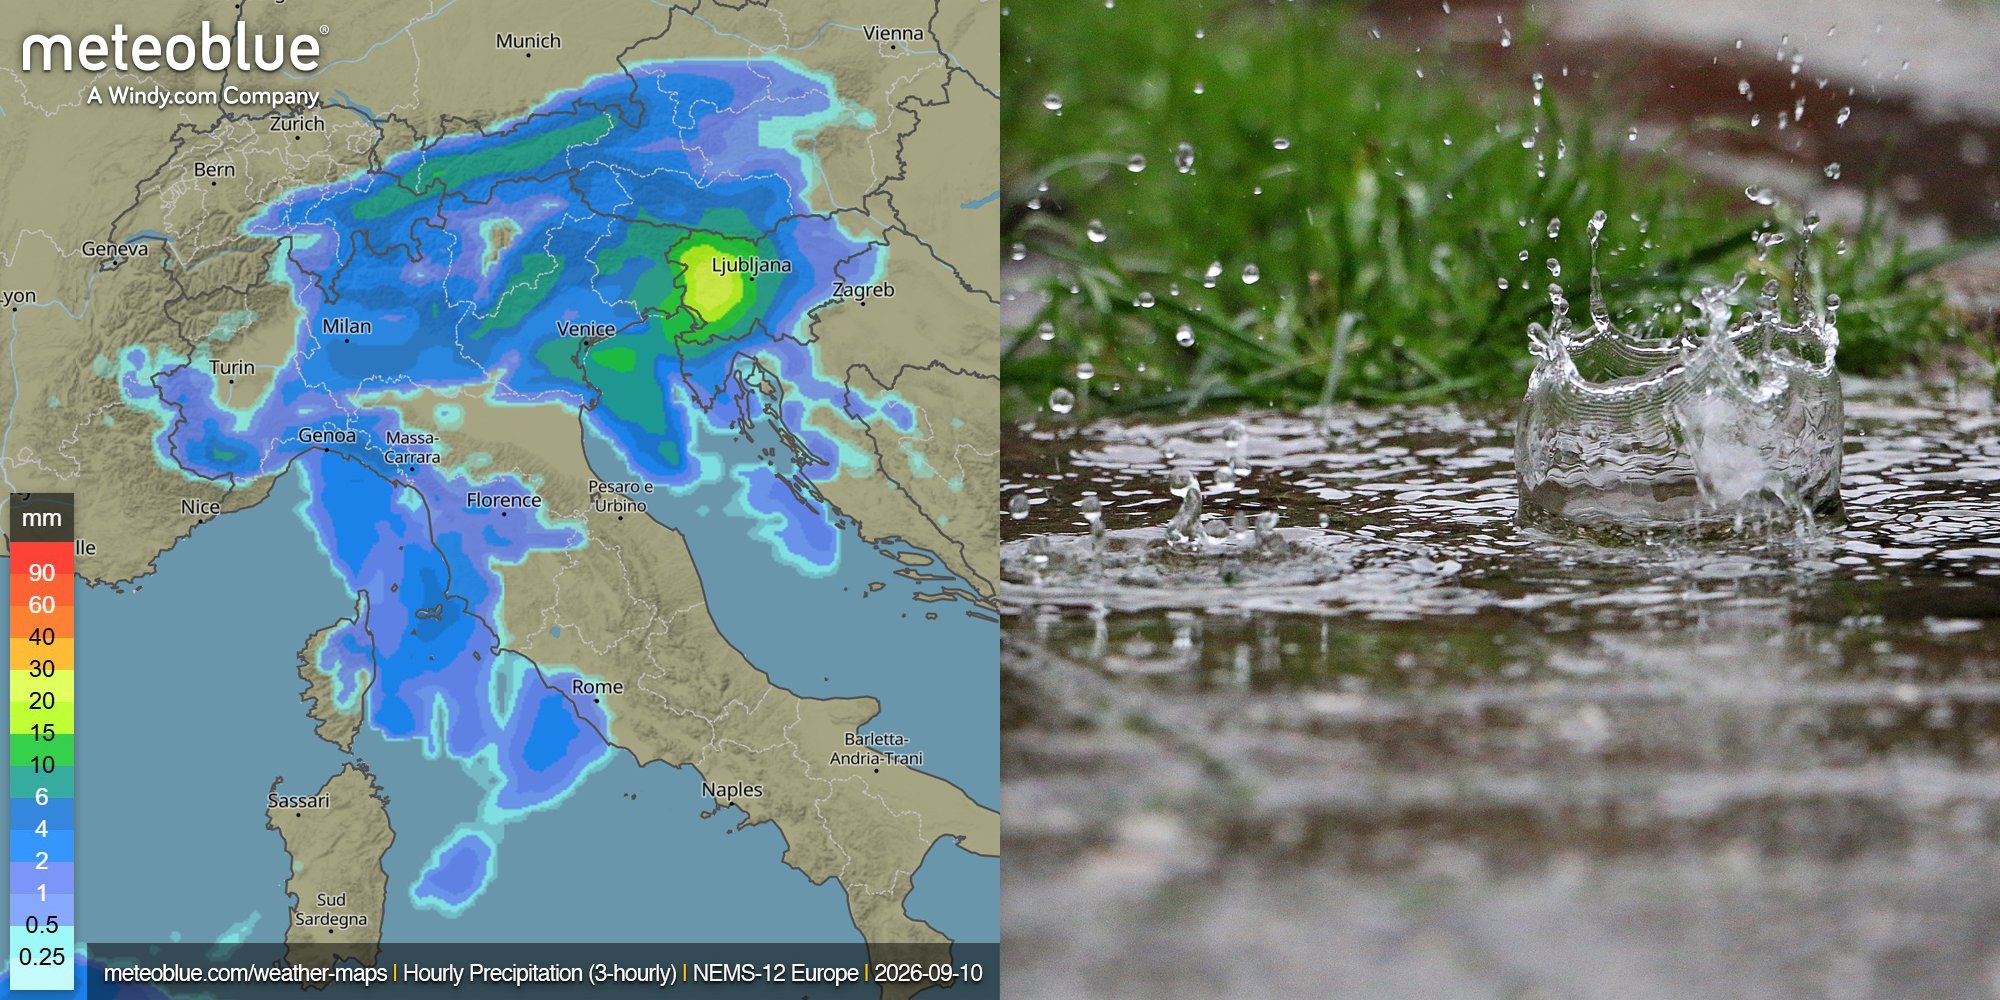
Ad esempio, un accumulo di precipitazioni su tre ore che termina alle 12:00 rappresenta la quantità d’acqua accumulata tra le 09:00 e le 12:00, non la quantità che cade a mezzogiorno. Per confrontarlo con le precipitazioni orarie, è necessario tenere conto dei diversi periodi di accumulo. Il valore originale su tre ore, inoltre, non indica esattamente quando sia caduta la pioggia all’interno di quel periodo.
Questa preparazione può rimanere invisibile agli utenti, ma evita che differenze nel formato o nelle definizioni dei dati vengano scambiate per differenze reali nelle previsioni meteorologiche.
Perché una cella della griglia non equivale a un luogo
I modelli numerici rappresentano l’atmosfera e la superficie terrestre mediante griglie. Una cella della griglia può comprendere una combinazione di pendii, edifici, vegetazione e superfici d’acqua, mentre l’altitudine rappresentata nel modello può differire da quella del luogo richiesto. Gli elementi più piccoli del terreno possono risultare smussati, soprattutto nei modelli a risoluzione più bassa.
Consideriamo, ad esempio, una località in una valle e una cima vicina all’interno della stessa cella della griglia a bassa risoluzione. La loro vicinanza non significa che abbiano la stessa temperatura, la stessa esposizione al vento o le stesse condizioni di precipitazione. Il primo compito consiste quindi nel collegare le coordinate richieste alle informazioni rilevanti del modello nelle aree circostanti, anziché considerare semplicemente il valore di una singola cella della griglia come la previsione.
La meteoblue Forecast API, ad esempio, produce previsioni puntuali utilizzando i dati dei modelli circostanti, informazioni sul terreno e post-processamento. Gli utenti possono specificare l’altitudine del luogo sul livello del mare; in caso contrario, l’API la determina utilizzando un modello digitale di elevazione con una risoluzione di 80 metri. Gli adattamenti legati all’altitudine influiscono su diverse variabili, tra cui temperatura e pressione.
Tuttavia, un dataset del terreno con una risoluzione di 80 metri non significa che l’atmosfera sia stata simulata su una griglia di 80 metri. Gli adattamenti locali aumentano la rilevanza di una previsione puntuale, ma non possono ricostruire ogni elemento non risolto dal modello, come il flusso d’aria attorno a un singolo edificio o un rovescio su scala molto ridotta. La risoluzione nativa del modello e il post-processamento locale rimangono quindi due aspetti distinti.
Decidere quali modelli devono contribuire
Disporre di diverse previsioni non permette automaticamente di individuare quella più utile. Una semplice media può mantenere errori condivisi da più modelli, mentre scegliere sempre lo stesso modello non tiene conto delle variazioni delle sue prestazioni tra luoghi e condizioni differenti.
Il meteoblue Learning MultiModel (mLM) utilizza informazioni sulle prestazioni previsionali precedenti per determinare una combinazione di modelli adeguata a un luogo specifico, considerando generalmente le prestazioni dei 60 giorni precedenti.
Questo processo può comprendere diverse forme di post-processamento. La selezione individua un modello di input adeguato, la ponderazione determina quanto contribuiscono i diversi modelli, il blending combina informazioni provenienti da più previsioni e la correzione interviene sugli errori sistematici. Ad esempio, scegliere un modello con un errore medio inferiore è diverso dal correggere un bias ricorrente, anche se entrambi gli approcci possono migliorare la previsione finale. Quando sono disponibili misurazioni adeguate, queste possono inoltre contribuire a individuare e correggere bias previsionali locali.
Per il servizio meteoblue specifico per le stazioni, le misurazioni dei mesi precedenti possono essere utilizzate per adattare la combinazione dei modelli alle condizioni locali. Ciò consente di tenere conto delle differenze nelle prestazioni specifiche del sito che potrebbero non emergere da confronti più ampi tra modelli.
mLM non sostituisce i modelli meteorologici numerici. Si basa su di essi, utilizzandone le previsioni in modo da riflettere le prestazioni di ciascun modello per un determinato luogo e una determinata variabile. Attualmente mLM è implementato e validato per temperatura dell’aria, temperatura del punto di rugiada e velocità del vento. Altre variabili, tra cui precipitazioni, nuvolosità e radiazione, si basano su fonti di dati e metodi di elaborazione differenti; non si deve quindi presumere che lo stesso metodo venga applicato all’intera previsione.
Integrare le osservazioni più recenti
Per le ore successive, le osservazioni possono rivelare sviluppi che un run precedente del modello non ha rappresentato con precisione. Il radar può mostrare, ad esempio, che una fascia di precipitazioni arriva prima del previsto. Le stazioni meteorologiche possono rilevare una differenza locale di temperatura, mentre le immagini satellitari forniscono informazioni sulle nubi e sul loro movimento. Le osservazioni dei fulmini possono fornire ulteriori informazioni sull’attività temporalesca.
Le previsioni a breve termine basate sulle osservazioni sono note come nowcasting. In meteoblue vengono utilizzate informazioni aggiornate frequentemente provenienti da stazioni, radar o satelliti. Il loro contributo dipende dalla variabile e dalla copertura disponibile: un’immagine radar può, ad esempio, contribuire a definire con maggiore precisione la tempistica delle precipitazioni, ma non misura direttamente la temperatura dell’aria presso una stazione meteorologica.
Questi metodi sono particolarmente utili per le previsioni a brevissimo termine. La loro utilità diminuisce man mano che i fenomeni meteorologici si sviluppano, si indeboliscono o cambiano direzione; per le previsioni più lontane nel tempo, i modelli numerici diventano quindi essenziali.
Rendere utilizzabili i dati elaborati
La previsione elaborata deve quindi essere presentata in una forma utilizzabile sia dalle persone sia dai software. A seconda del prodotto, ciò comprende temperatura, precipitazioni, vento, raffiche, nuvolosità e altre variabili, fornite sotto forma di serie temporali, diagrammi o dati API strutturati. I valori orari consentono una pianificazione dettagliata, mentre i riepiloghi giornalieri offrono una panoramica più ampia.
Un singolo valore di previsione dovrebbe inoltre essere accompagnato da informazioni sull’incertezza. La prevedibilità di meteoblue descrive il grado di certezza stimato della previsione, mentre la probabilità di precipitazione riguarda la probabilità che si verifichino precipitazioni. Le due informazioni rispondono a domande diverse: la certezza della previsione complessiva non equivale alla probabilità di precipitazioni.
La previsione puntuale finale, quindi, non è sempre l’output diretto di un singolo modello. Combina le informazioni disponibili in un’unica stima ottimale, riflettendo al contempo l’incertezza residua.
Perché le previsioni cambiano tra un aggiornamento e l’altro
Una previsione viene continuamente aggiornata man mano che diventano disponibili nuove informazioni. Nuovi run dei modelli possono modificare l’evoluzione prevista, mLM può aggiornare la combinazione di modelli preferita e le osservazioni recenti possono influenzare la previsione a breve termine.
Per gli utenti, ciò può significare, ad esempio, una variazione dell’orario previsto per l’inizio della pioggia o un aggiornamento della temperatura prevista per domani pomeriggio. Una modifica della previsione non significa automaticamente che la versione precedente fosse scadente. Riflette il fatto che sono state aggiunte informazioni più recenti e il suo valore può essere valutato solo confrontando la previsione con ciò che è realmente accaduto.
Confrontare il risultato con la realtà
La catena di elaborazione necessita di un metodo per stabilire se apporta effettivamente un valore aggiunto. La verifica delle previsioni confronta le previsioni con osservazioni adeguate per numerosi luoghi e momenti. I meteoblue Forecast Accuracy Reports mensili valutano mLM sulla base di dati di stazioni meteorologiche sottoposti a controllo di qualità e ne confrontano le prestazioni con quelle dei modelli globali per temperatura, punto di rugiada e velocità del vento.
Un confronto equo deve tenere conto della variabile meteorologica, del momento di validità e dell’orizzonte previsionale. Una previsione emessa diversi giorni prima di un evento rappresenta un test diverso rispetto a un aggiornamento effettuato poco prima dell’evento. La verifica oraria consente inoltre di rilevare errori nella tempistica che possono non emergere quando vengono valutati esclusivamente valori giornalieri.
Metriche diverse evidenziano debolezze diverse. Il Mean Absolute Error (MAE) descrive l’entità media degli errori, il Mean Error (ME) identifica sovrastime o sottostime sistematiche e il Root Mean Square Error (RMSE) attribuisce un peso maggiore agli errori più grandi. Utilizzate insieme, queste metriche aiutano a stabilire se una previsione fornisce risultati costantemente buoni anziché essere precisa solo occasionalmente.
La verifica fornisce inoltre un feedback per ulteriori sviluppi. Un metodo di elaborazione può funzionare bene in una determinata regione o stagione, ma meno bene altrove. Valutazioni ripetute aiutano a individuare queste differenze e a verificare se le modifiche apportate migliorano le prestazioni nel tempo. I meteoblue Forecast Accuracy Reports permettono di seguire questi risultati.
La previsione continua dopo il run del modello
La qualità di un servizio meteorologico dipende sia dai modelli utilizzati sia dal modo in cui i loro output vengono elaborati. Rendere confrontabili i dataset, adattarli a un luogo, imparare dagli errori precedenti e integrare osservazioni adeguate contribuisce a trasformare una simulazione modellistica in una previsione utilizzabile.
Per meteoblue, queste funzioni operano insieme per produrre informazioni rilevanti a livello locale. La verifica continua consente poi di valutare il risultato. Una previsione può apparire semplice sullo schermo, ma prima che venga visualizzato il valore finale sono già avvenute numerose fasi di elaborazione.
Avete una domanda o un’idea da condividere? Visitate il meteoblue Community Forum e continuate la conversazione con altri appassionati di meteorologia.